Evidens
Coleta de acórdãos do TJRJ e análise semântica com LLM, cada afirmação provada por citação literal verificada
- Python
- Playwright
- BeautifulSoup
- PostgreSQL
- psycopg 3
- PyMuPDF
- Codex CLI
- Flask
- React
- TypeScript
- Vite
- Recharts
- Docker
- pytest
O Evidens é um pipeline em Python que coleta acórdãos do Tribunal de Justiça do Rio de Janeiro (TJRJ), extrai o texto dos PDFs e faz um modelo de linguagem ler cada decisão inteira, provando cada afirmação com uma citação literal. Construí o projeto para ajudar uma amiga no TCC de Direito, que estuda como o tribunal justifica acolher, afastar ou relativizar a perícia em apelações por alegado erro médico.
Para quem não é da área: acórdão é a decisão de um grupo de desembargadores ao julgar um recurso, e perícia é o exame técnico feito por um especialista nomeado pelo juiz, registrado num laudo. O código é privado e nenhum dado de processo aparece aqui de propósito; o que segue é como resolvi cada parte.
Visão geral
Cada etapa é um comando de uma CLI própria: coletar, baixar, extrair, triar o escopo, analisar, sortear a amostra da auditoria cega e gerar o relatório. O PostgreSQL 16 guarda tudo em três schemas: raw com a evidência como foi coletada, core com os documentos únicos e analysis com as fichas do modelo e a proveniência. É SQL puro com psycopg 3, em 13 migrações idempotentes.
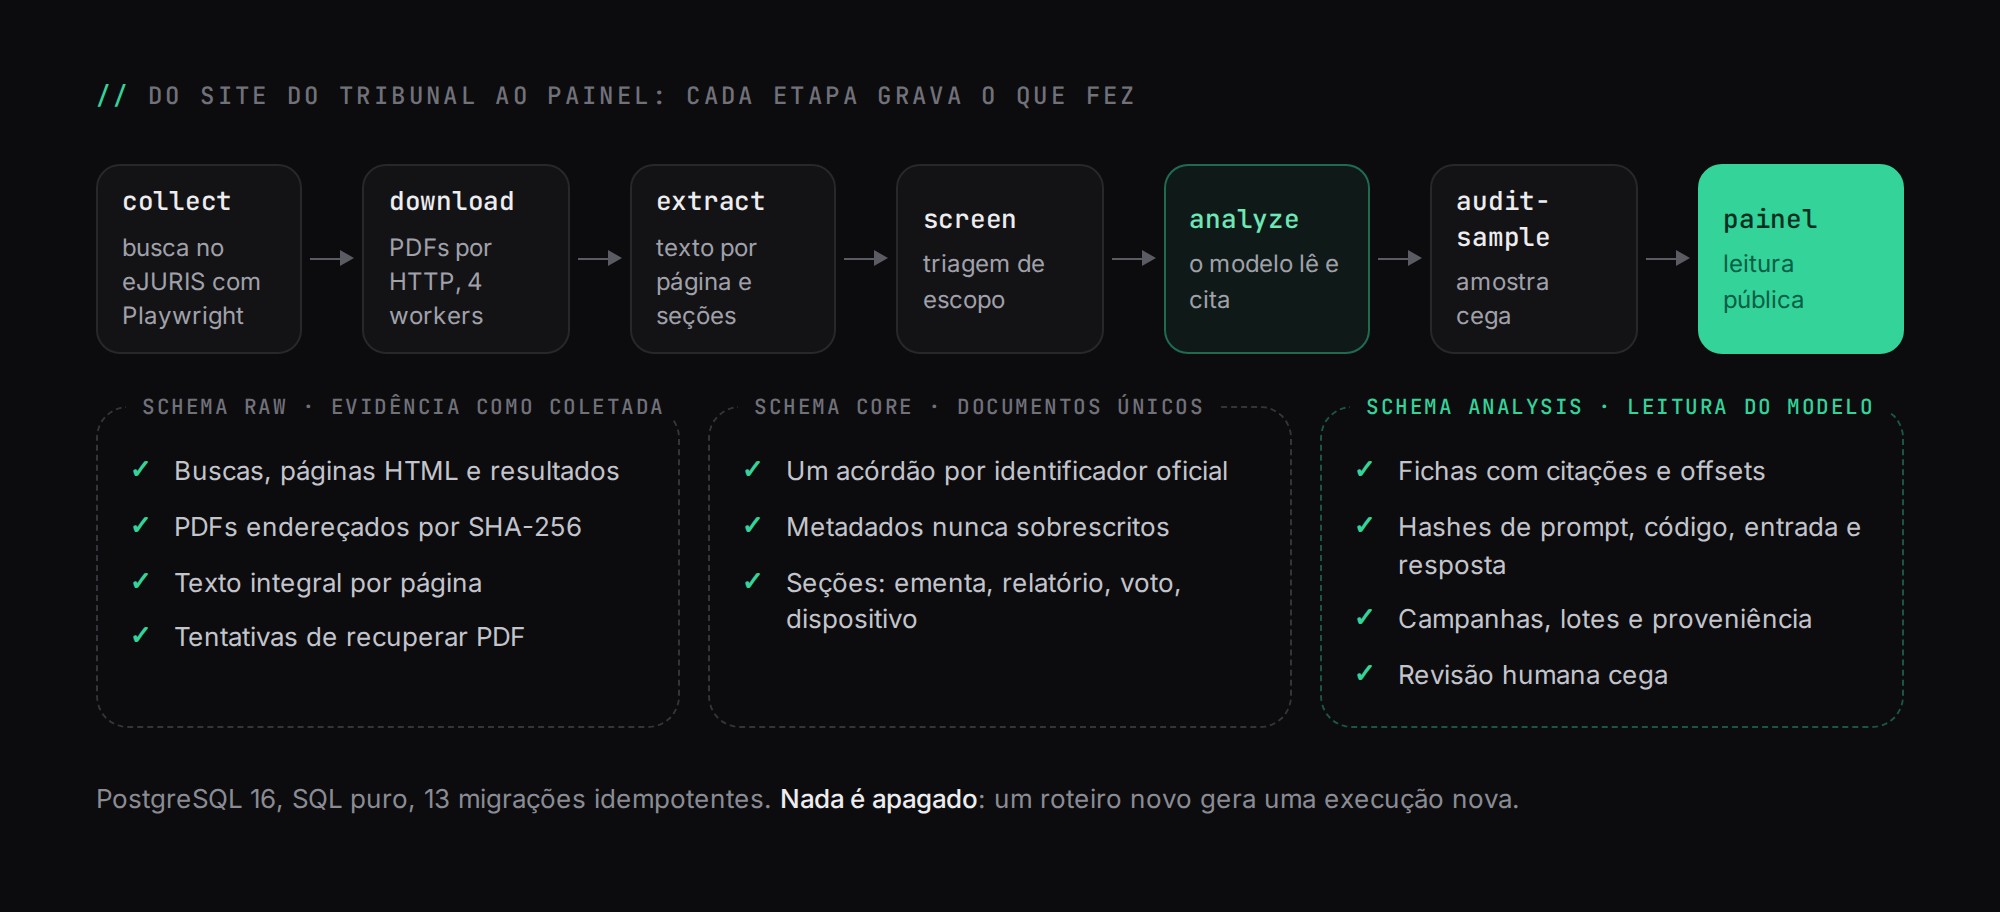
Coleta auditável num site que não foi feito para isso
A busca do tribunal é um formulário ASP.NET. O Playwright marca "Acórdão", desmarca "Decisão Monocrática" e escolhe o ano; como o site às vezes reseta o ano após um postback, o coletor confere e tenta até três vezes. Cada busca é um registro com estado e pode ser retomada da última página salva; se o total informado pelo site muda no meio, a busca é abortada, porque a paginação deixou de ser confiável.
O HTML de cada página é salvo imutável, endereçado pelo SHA-256, com escrita atômica. O parser em BeautifulSoup levanta erro explícito quando o layout muda, em vez de devolver campos vazios. Os PDFs vêm por HTTP com allow-list de host, HTTPS obrigatório, limite de 50 MB e corpo que precisa começar com %PDF-. Quatro threads baixam bytes; toda escrita em disco e no banco fica na thread principal.
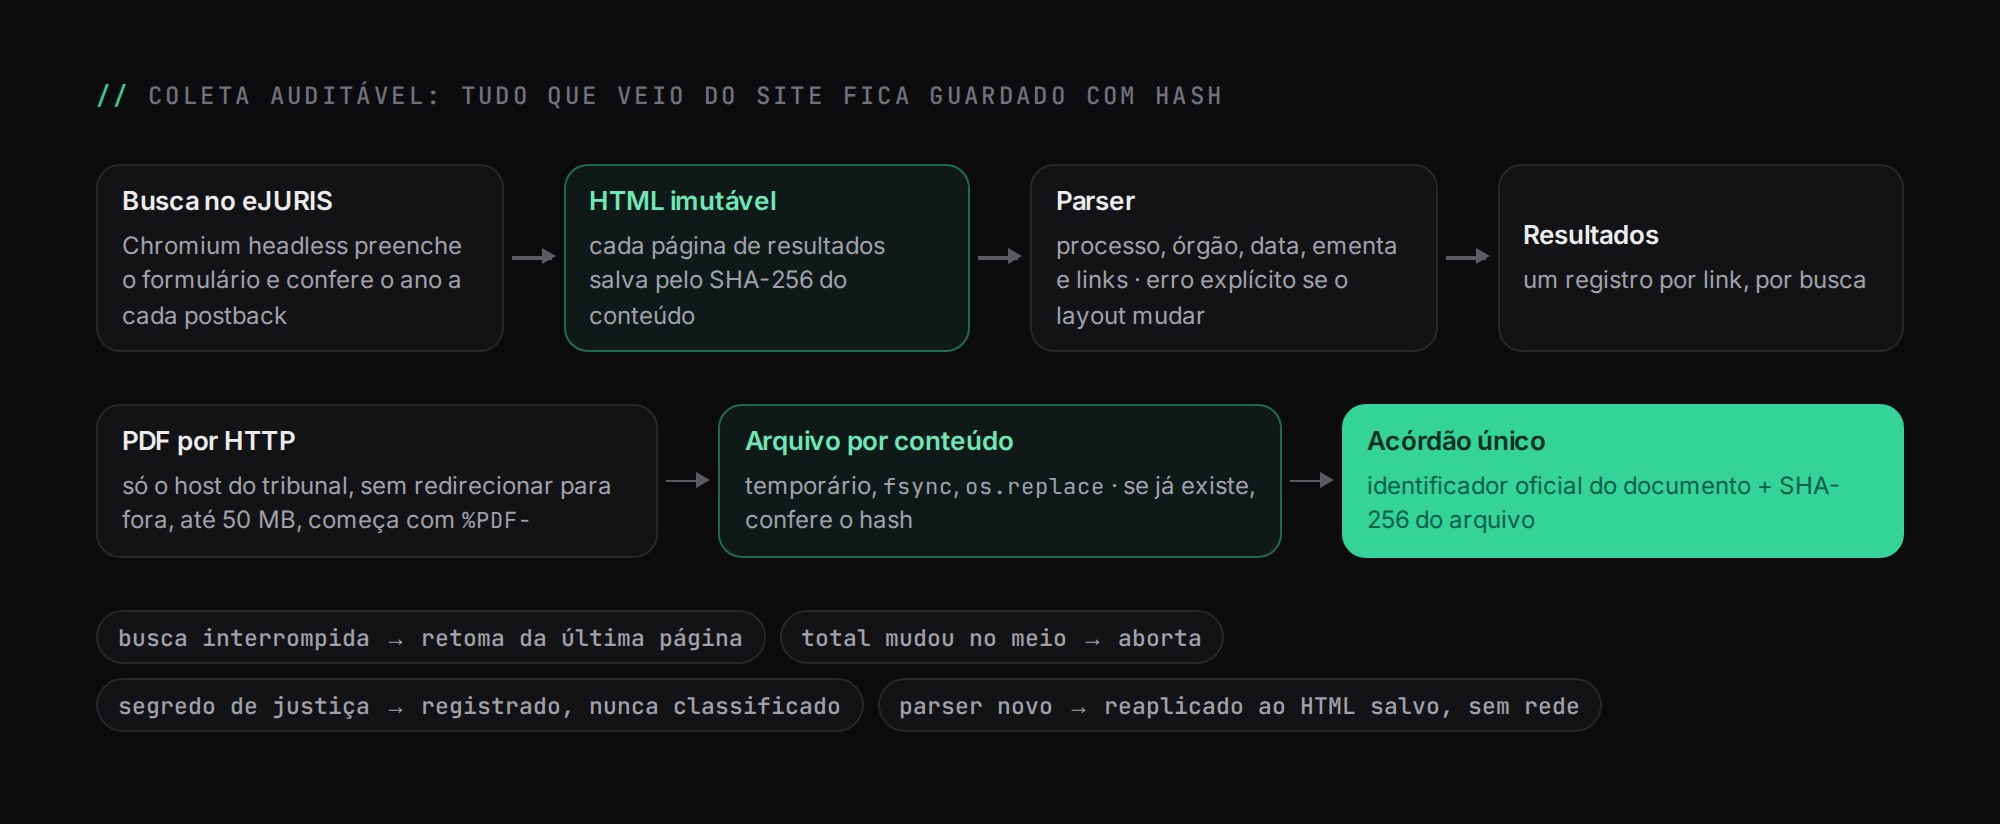
Nunca buscar a mesma coisa duas vezes
A deduplicação usa duas chaves: o identificador oficial do documento, com restrição UNIQUE, e o SHA-256 do arquivo. O mesmo acórdão achado por consultas diferentes vira um documento só, mas cada resultado de cada busca é preservado, e o upsert com COALESCE nunca sobrescreve metadado já conhecido. Processos em segredo de justiça e resultados sem PDF são registrados com o motivo e nunca classificados. O comando repair-pdfs reaplica o parser atual ao HTML salvo, sem rede, e só volta ao site para o que ficou sem PDF.
Extrair texto sem inventar
O PyMuPDF extrai o texto por página, e uma máquina de estados separa ementa, relatório, voto e dispositivo. Se falta a ementa no PDF, entra a do resultado da busca, marcada com método próprio. PDF com pouco texto vira ocr_needed; não implementei OCR, e o programa não preenche texto ausente.
Fazer um modelo ler 1.048 acórdãos e provar o que leu
A decisão inteira, com contrato de saída
O modelo é o GPT-6 Luna com reasoning effort alto, chamado pelo Codex CLI num subprocesso sem estado por documento, em sandbox somente leitura. A entrada é o acórdão inteiro, sem chunking nem embeddings; acima de 100 páginas ou 180 mil caracteres, o sistema se abstém e registra o motivo. O roteiro versionado trata o texto das páginas como dado não confiável, proíbe concluir que um argumento não existiu só porque o acórdão não o menciona e manda abster quando o texto não sustenta a avaliação.
A saída segue um JSON Schema fechado, revalidado em Python: elegibilidade, polo passivo (quem é o réu: ente público, privado ou ambos), tratamento do laudo, até 4 recursos e até 20 evidências. Regras de coerência em código impedem que o resumo contradiga a análise de cada recurso.
Citação literal ou nada
Cada citação precisa estar na página indicada. A conferência tem três passos: correspondência exata, depois com espaços e quebras de linha colapsados, depois ignorando espaços. Não há comparação aproximada nem reticências, e o texto guardado passa a ser o recorte exato da fonte, com offsets. Na falha, há uma única nova tentativa para corrigir só a evidência; se o modelo mudar a classificação nela, o resultado é rejeitado. A segunda falha fica registrada, com as duas respostas.
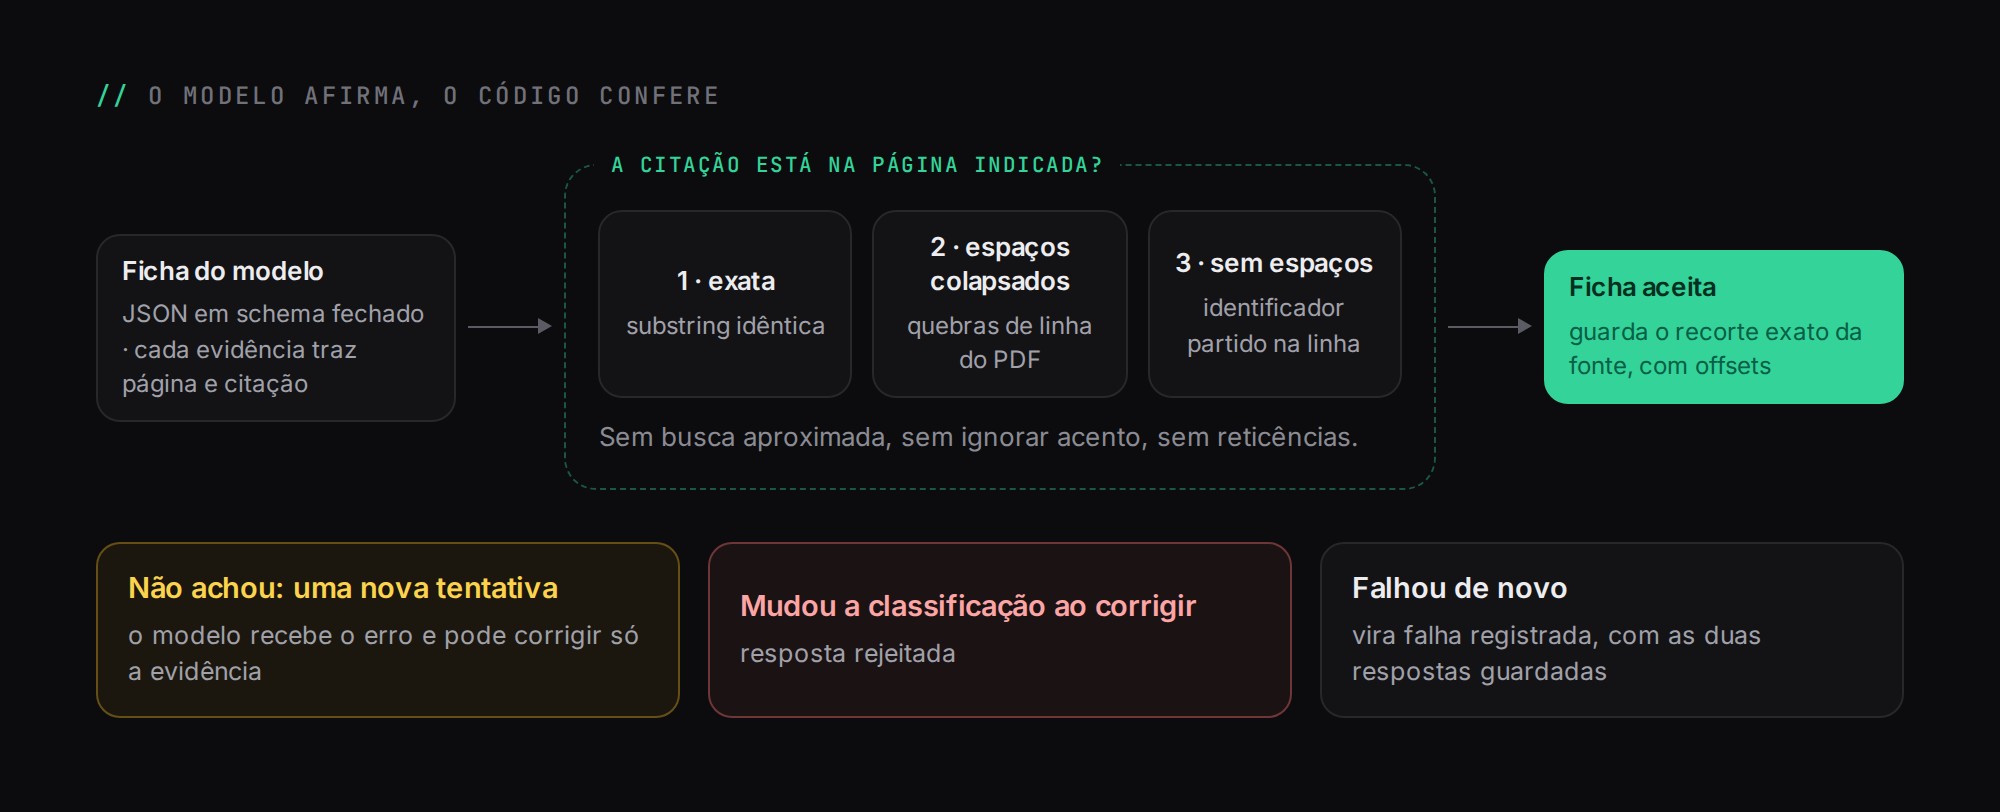
Cada ficha guarda o hash do prompt, do código do avaliador, da entrada, do PDF e da resposta bruta. Retomar uma execução é recusado se modelo, prompt ou código mudaram.
Escala com workers disjuntos
A coorte é congelada e dividida de forma determinística pelo tamanho do texto, o maior documento indo para o worker menos carregado. Um manifesto com hash por worker, uma tabela de atribuição e um advisory lock do PostgreSQL por caso garantem que nenhum documento seja lido duas vezes. A campanha final rodou em 18 execuções de 58 a 59 documentos, em cerca de 2 h 36 min. Antes disso, uma regex barata acha candidatos e o modelo só lê onde é preciso: na triagem de casos de odontologia, dos 90 candidatos ele descartou 29.
Os números
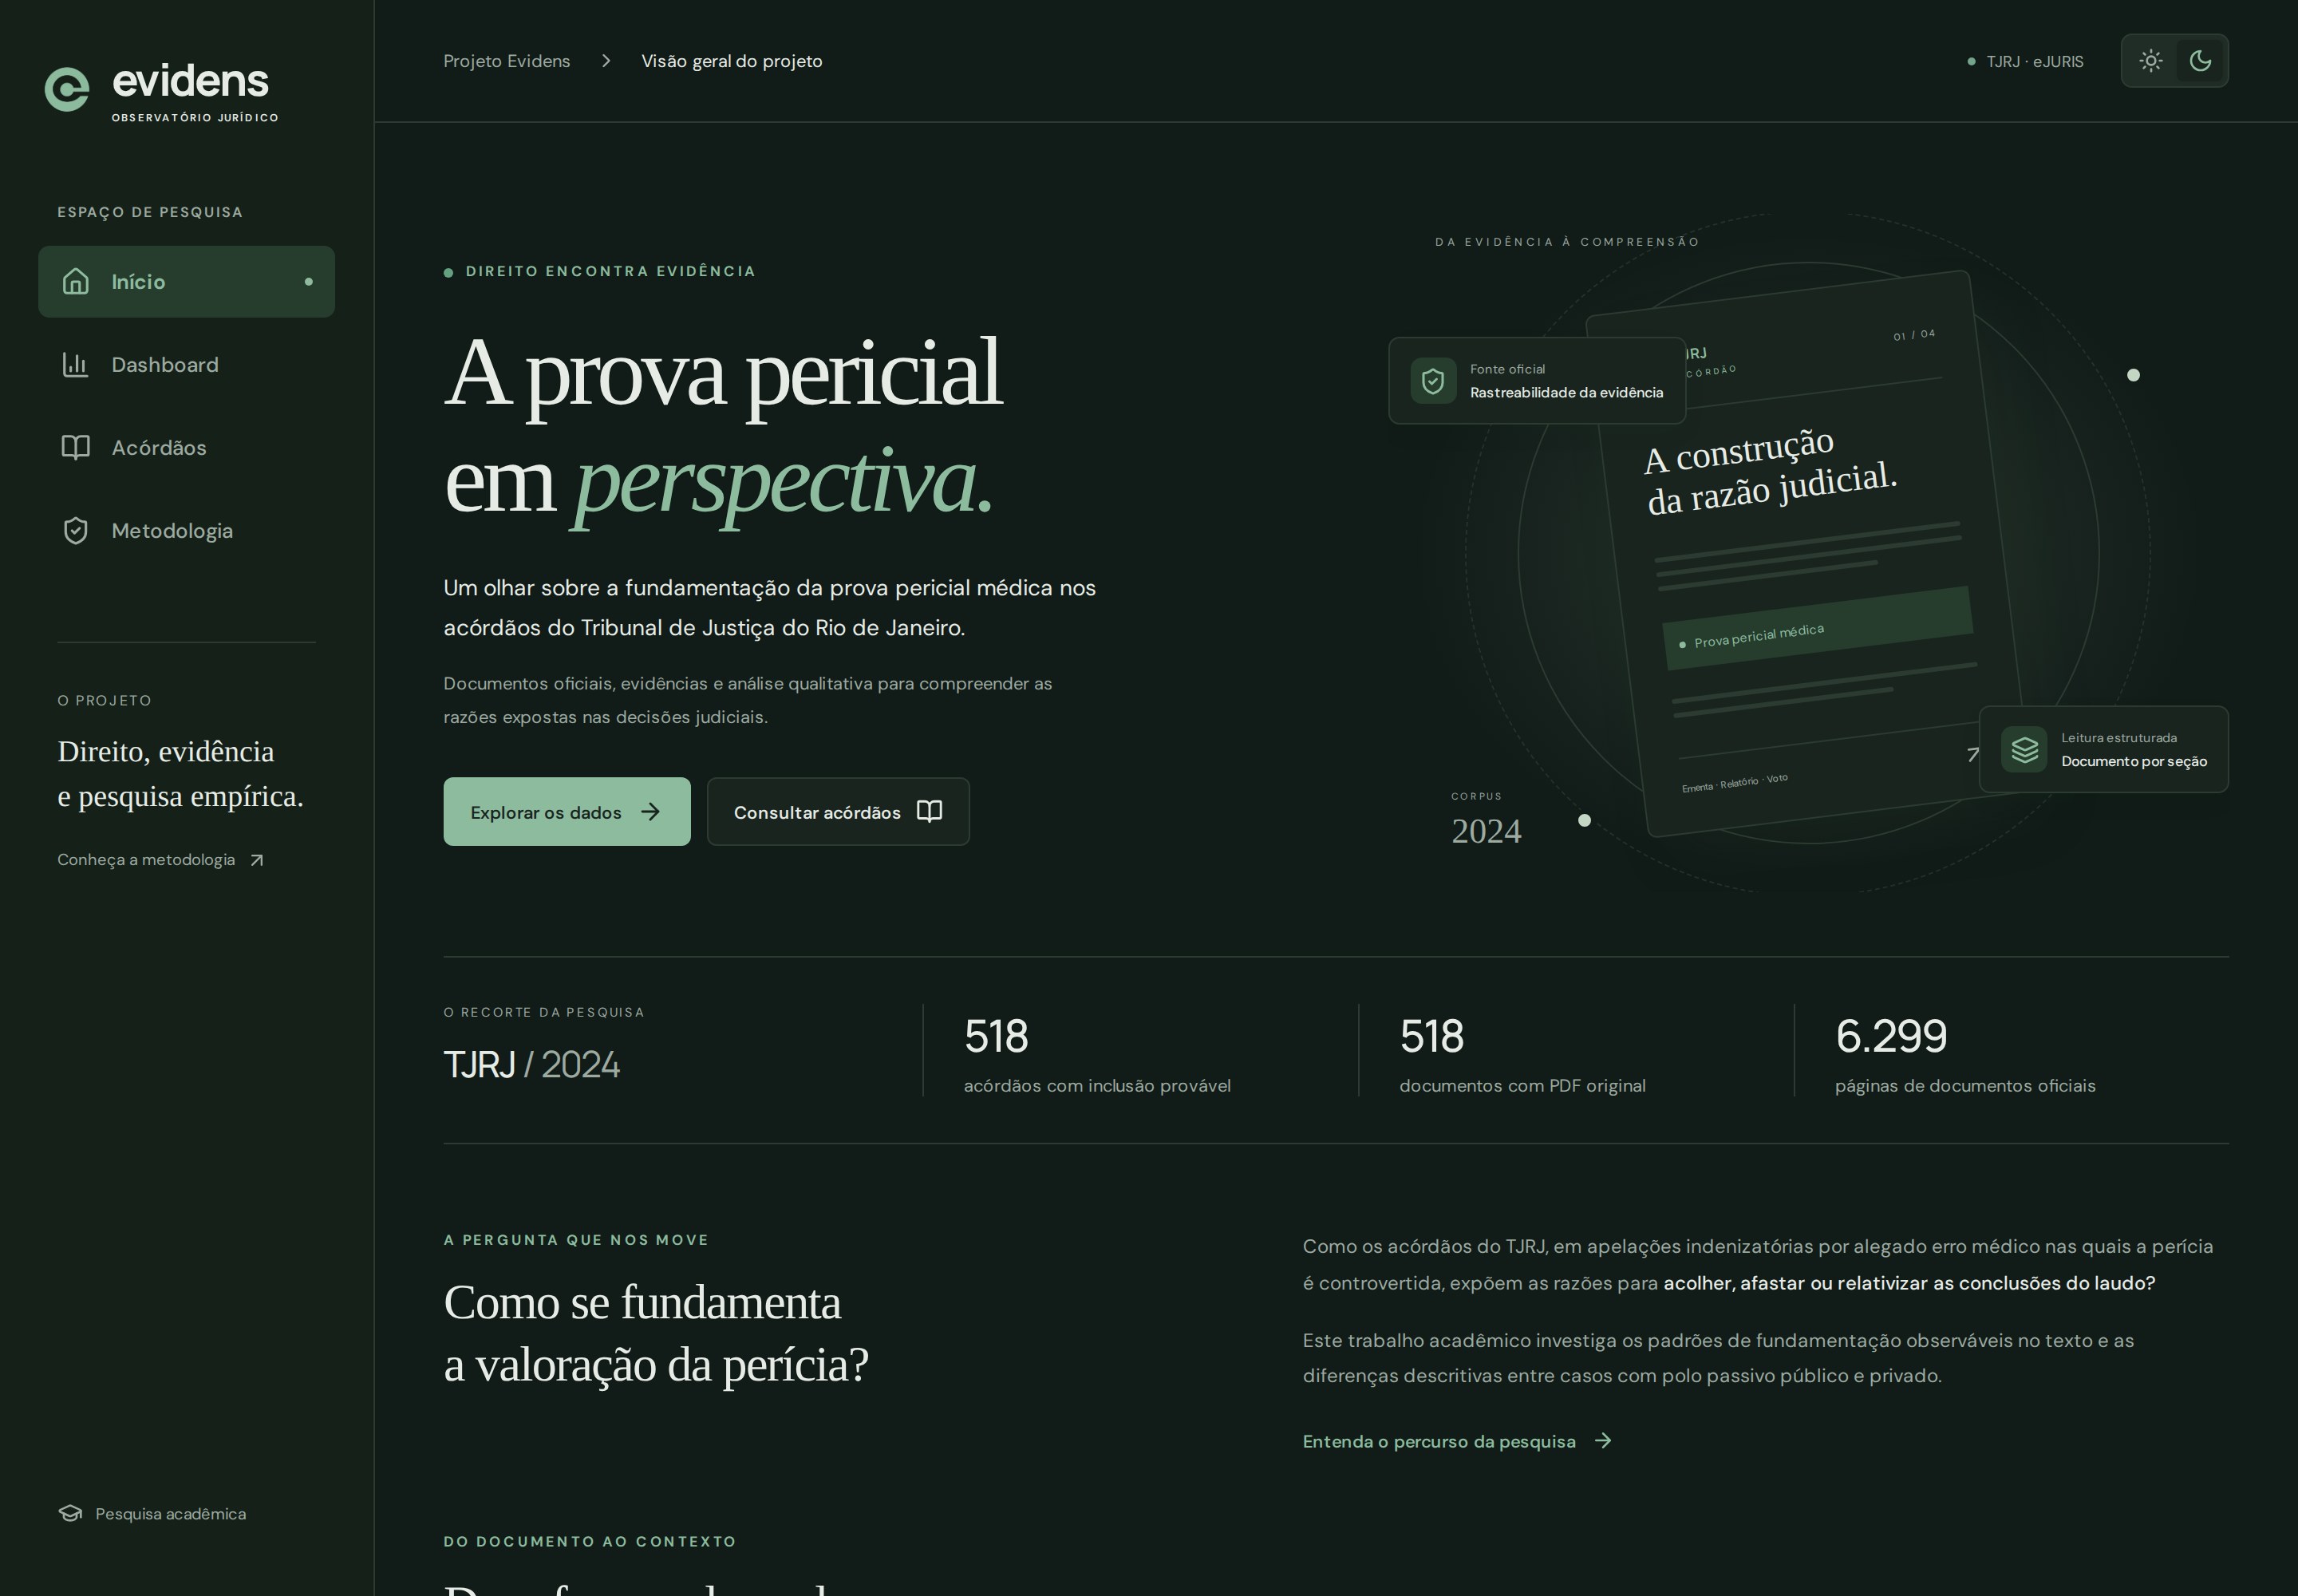
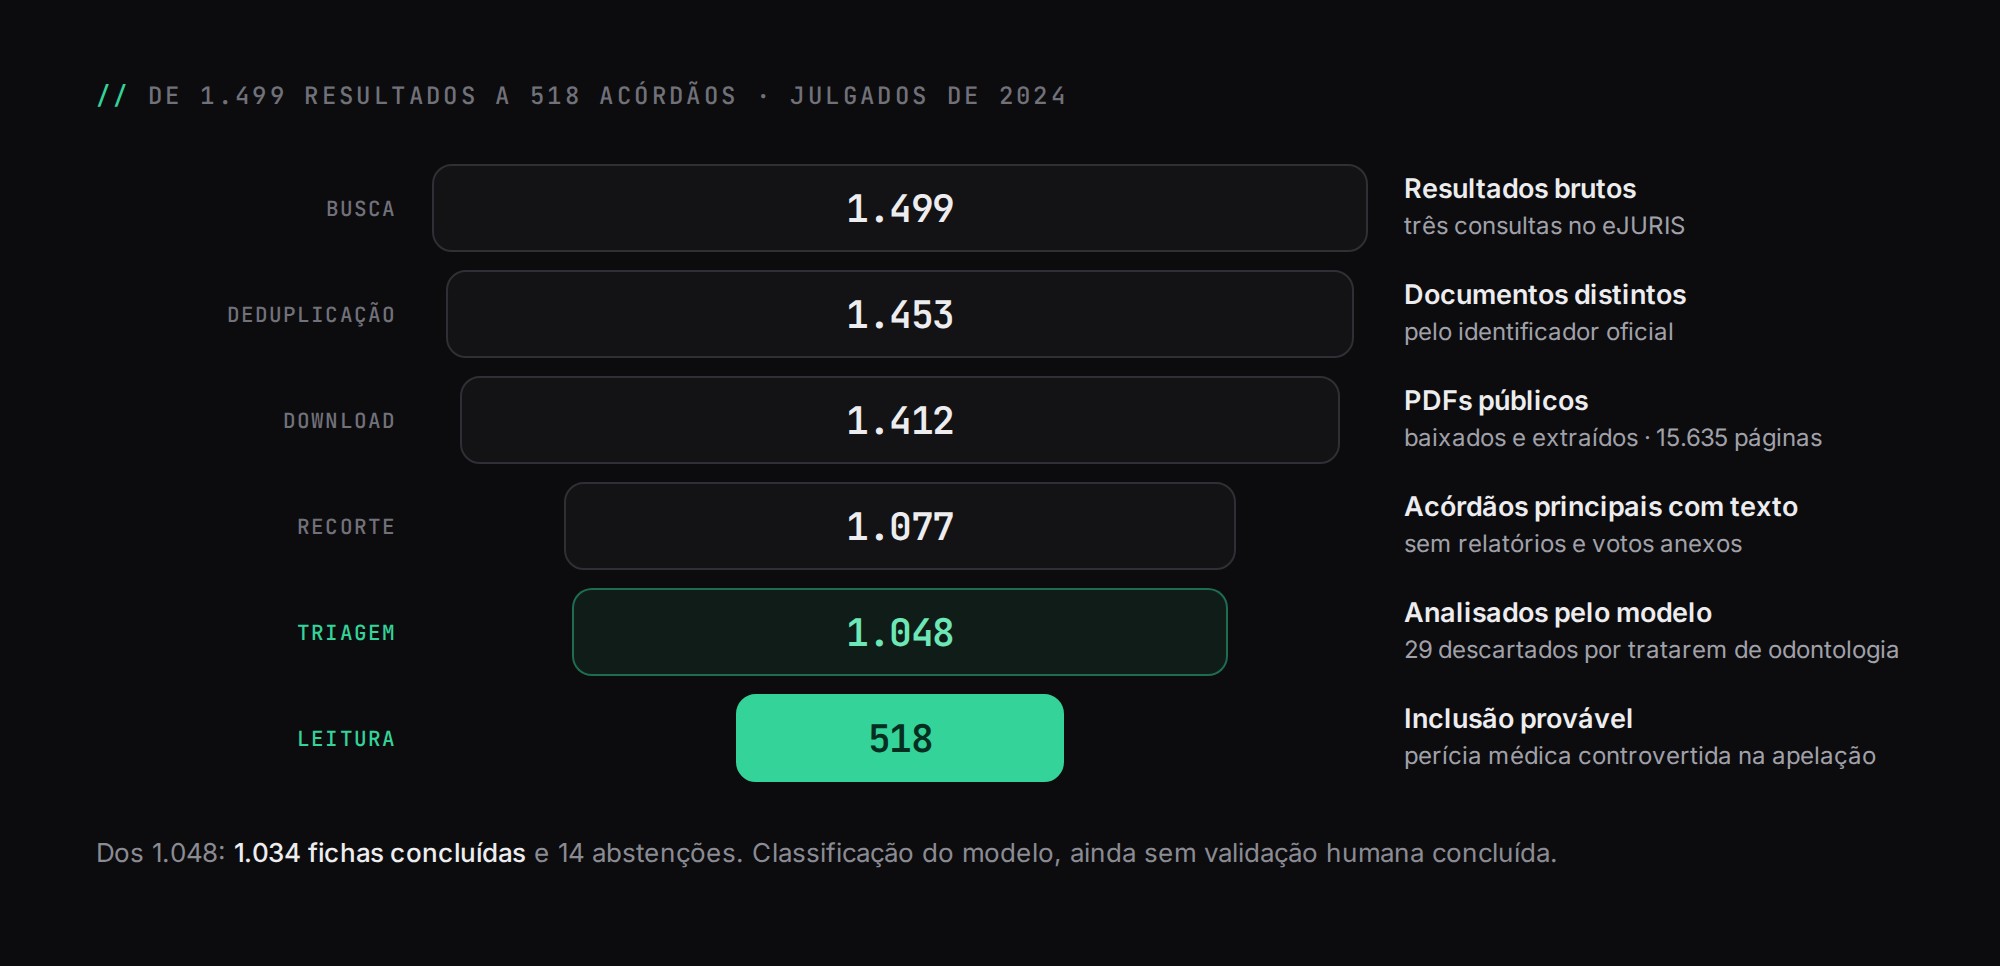
- 1.499 resultados brutos, 1.453 documentos distintos e 1.412 PDFs extraídos (15.635 páginas).
- 1.077 acórdãos principais com texto e 1.048 analisados: 1.034 fichas e 14 abstenções.
- 518 com inclusão provável, 486 excluídos e 44 incertos.
- 7.426 citações conferidas; 330 fichas precisaram de segunda tentativa.
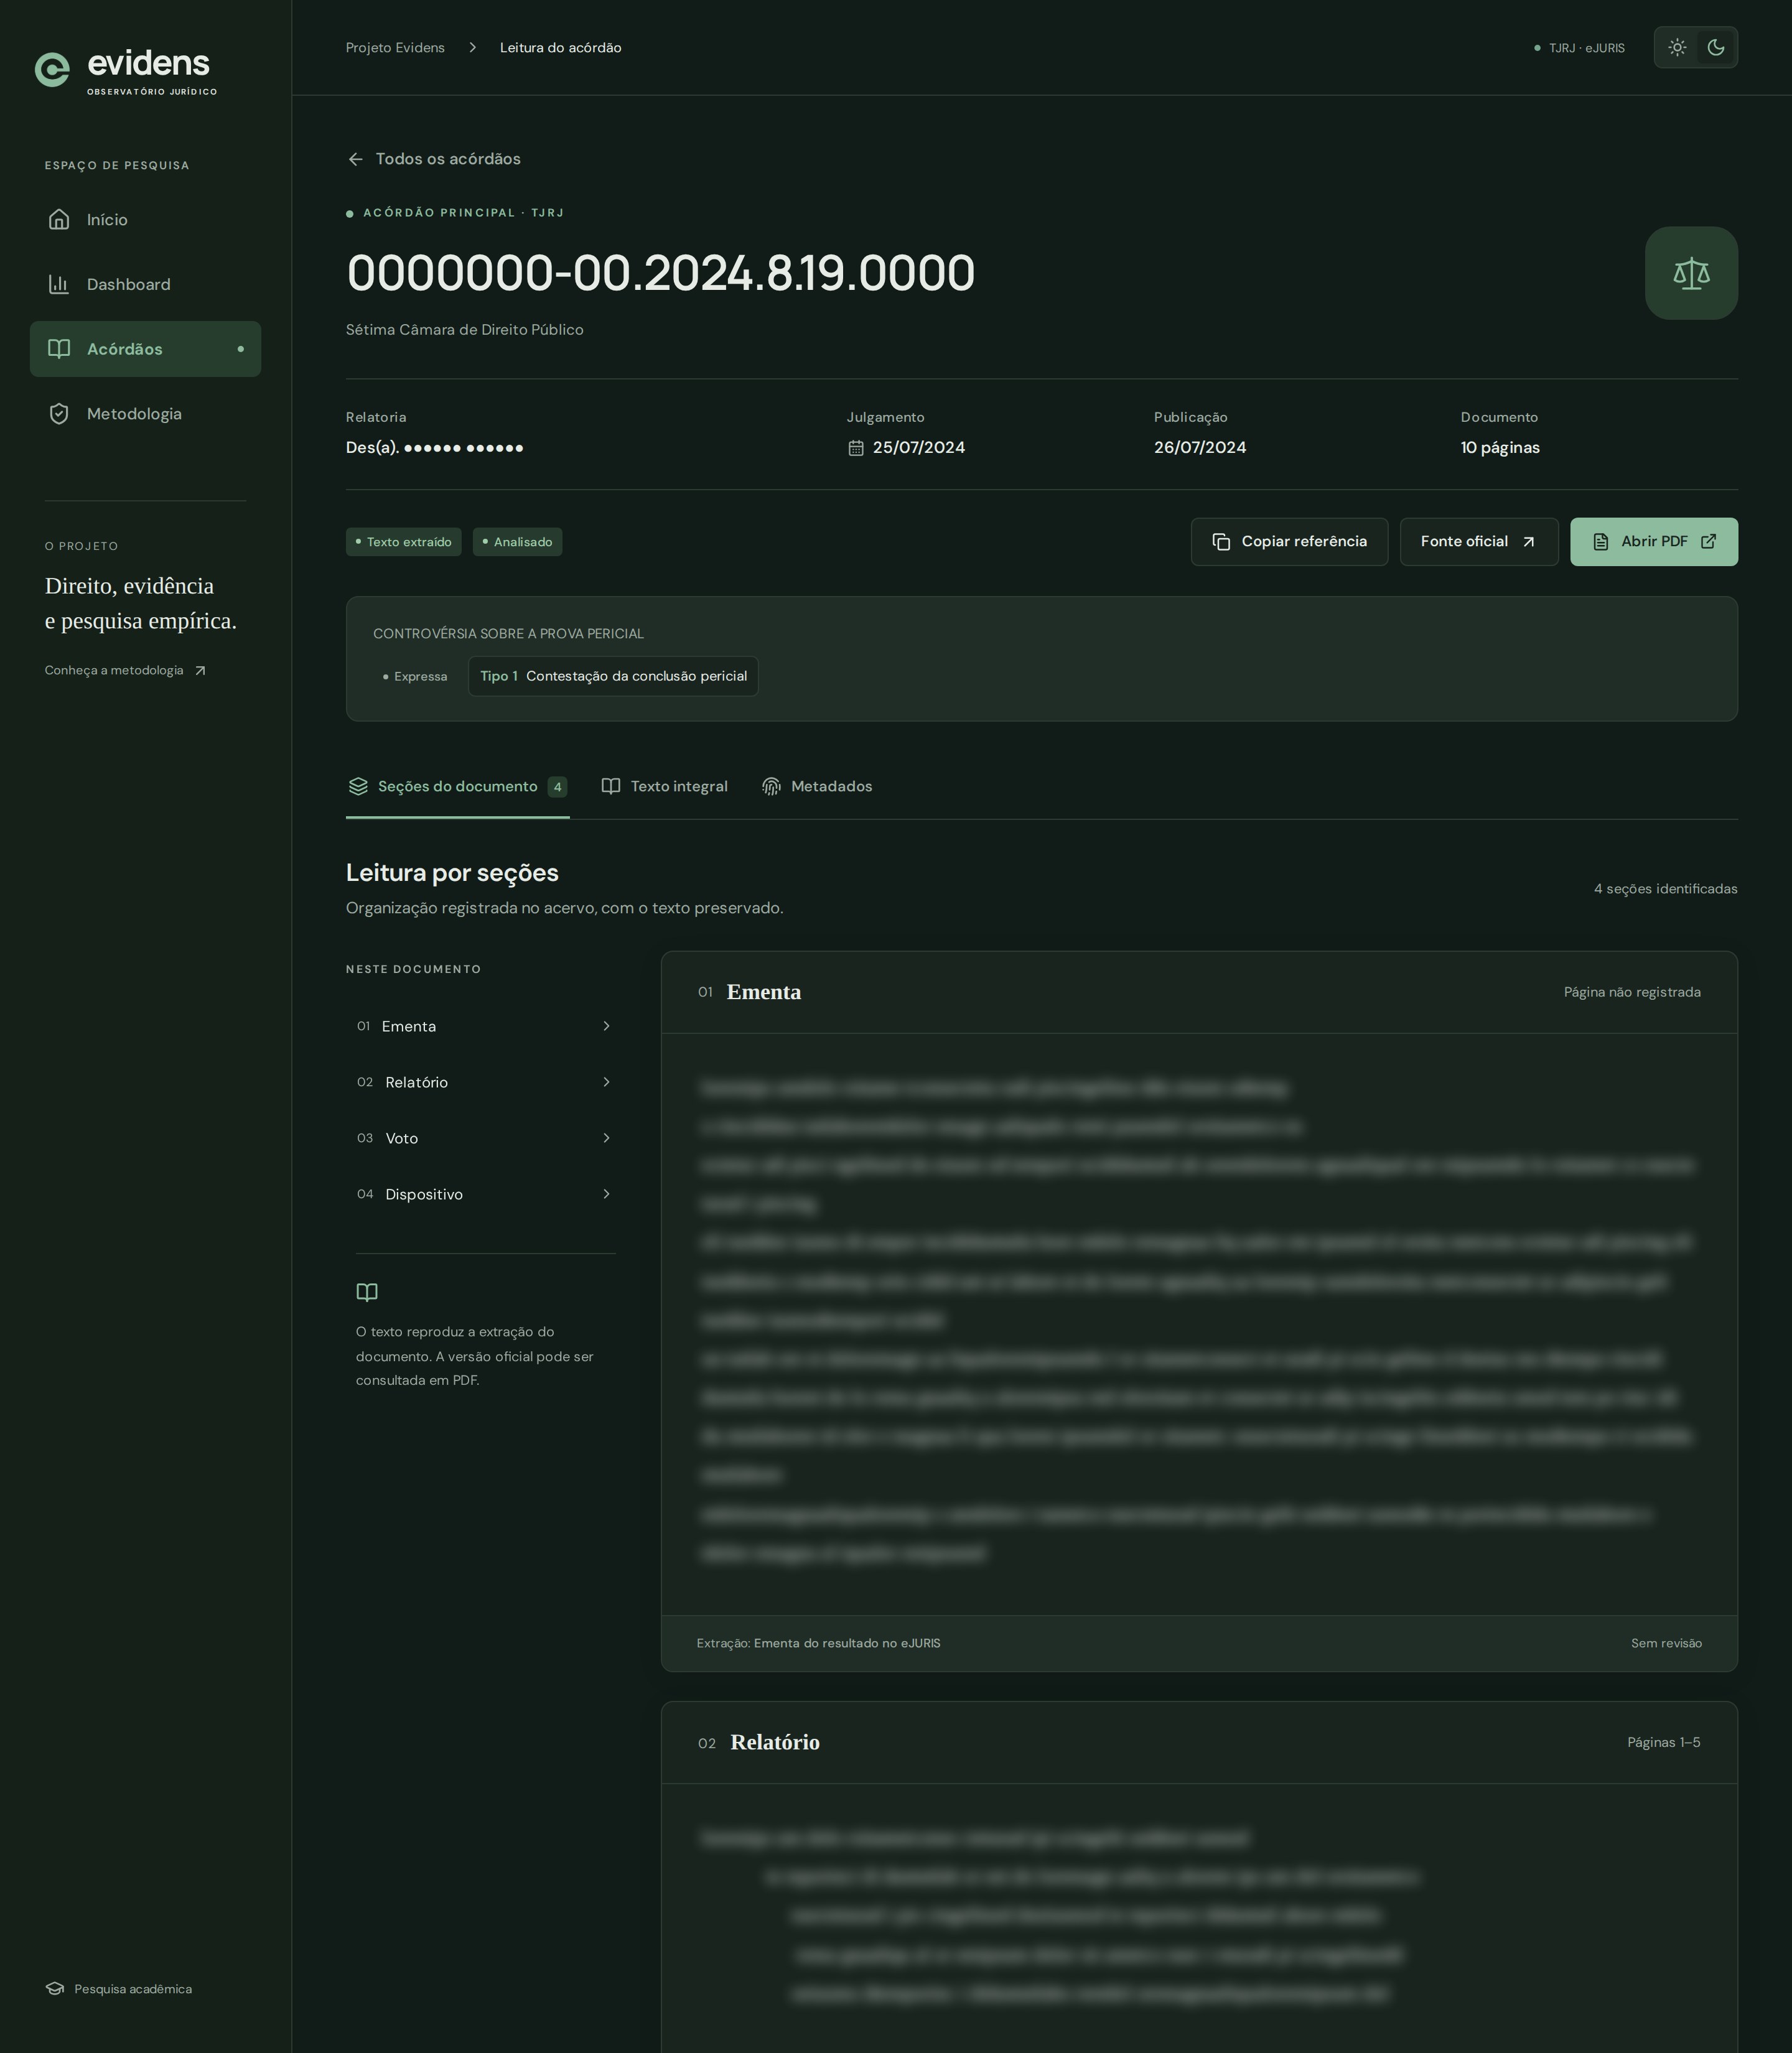
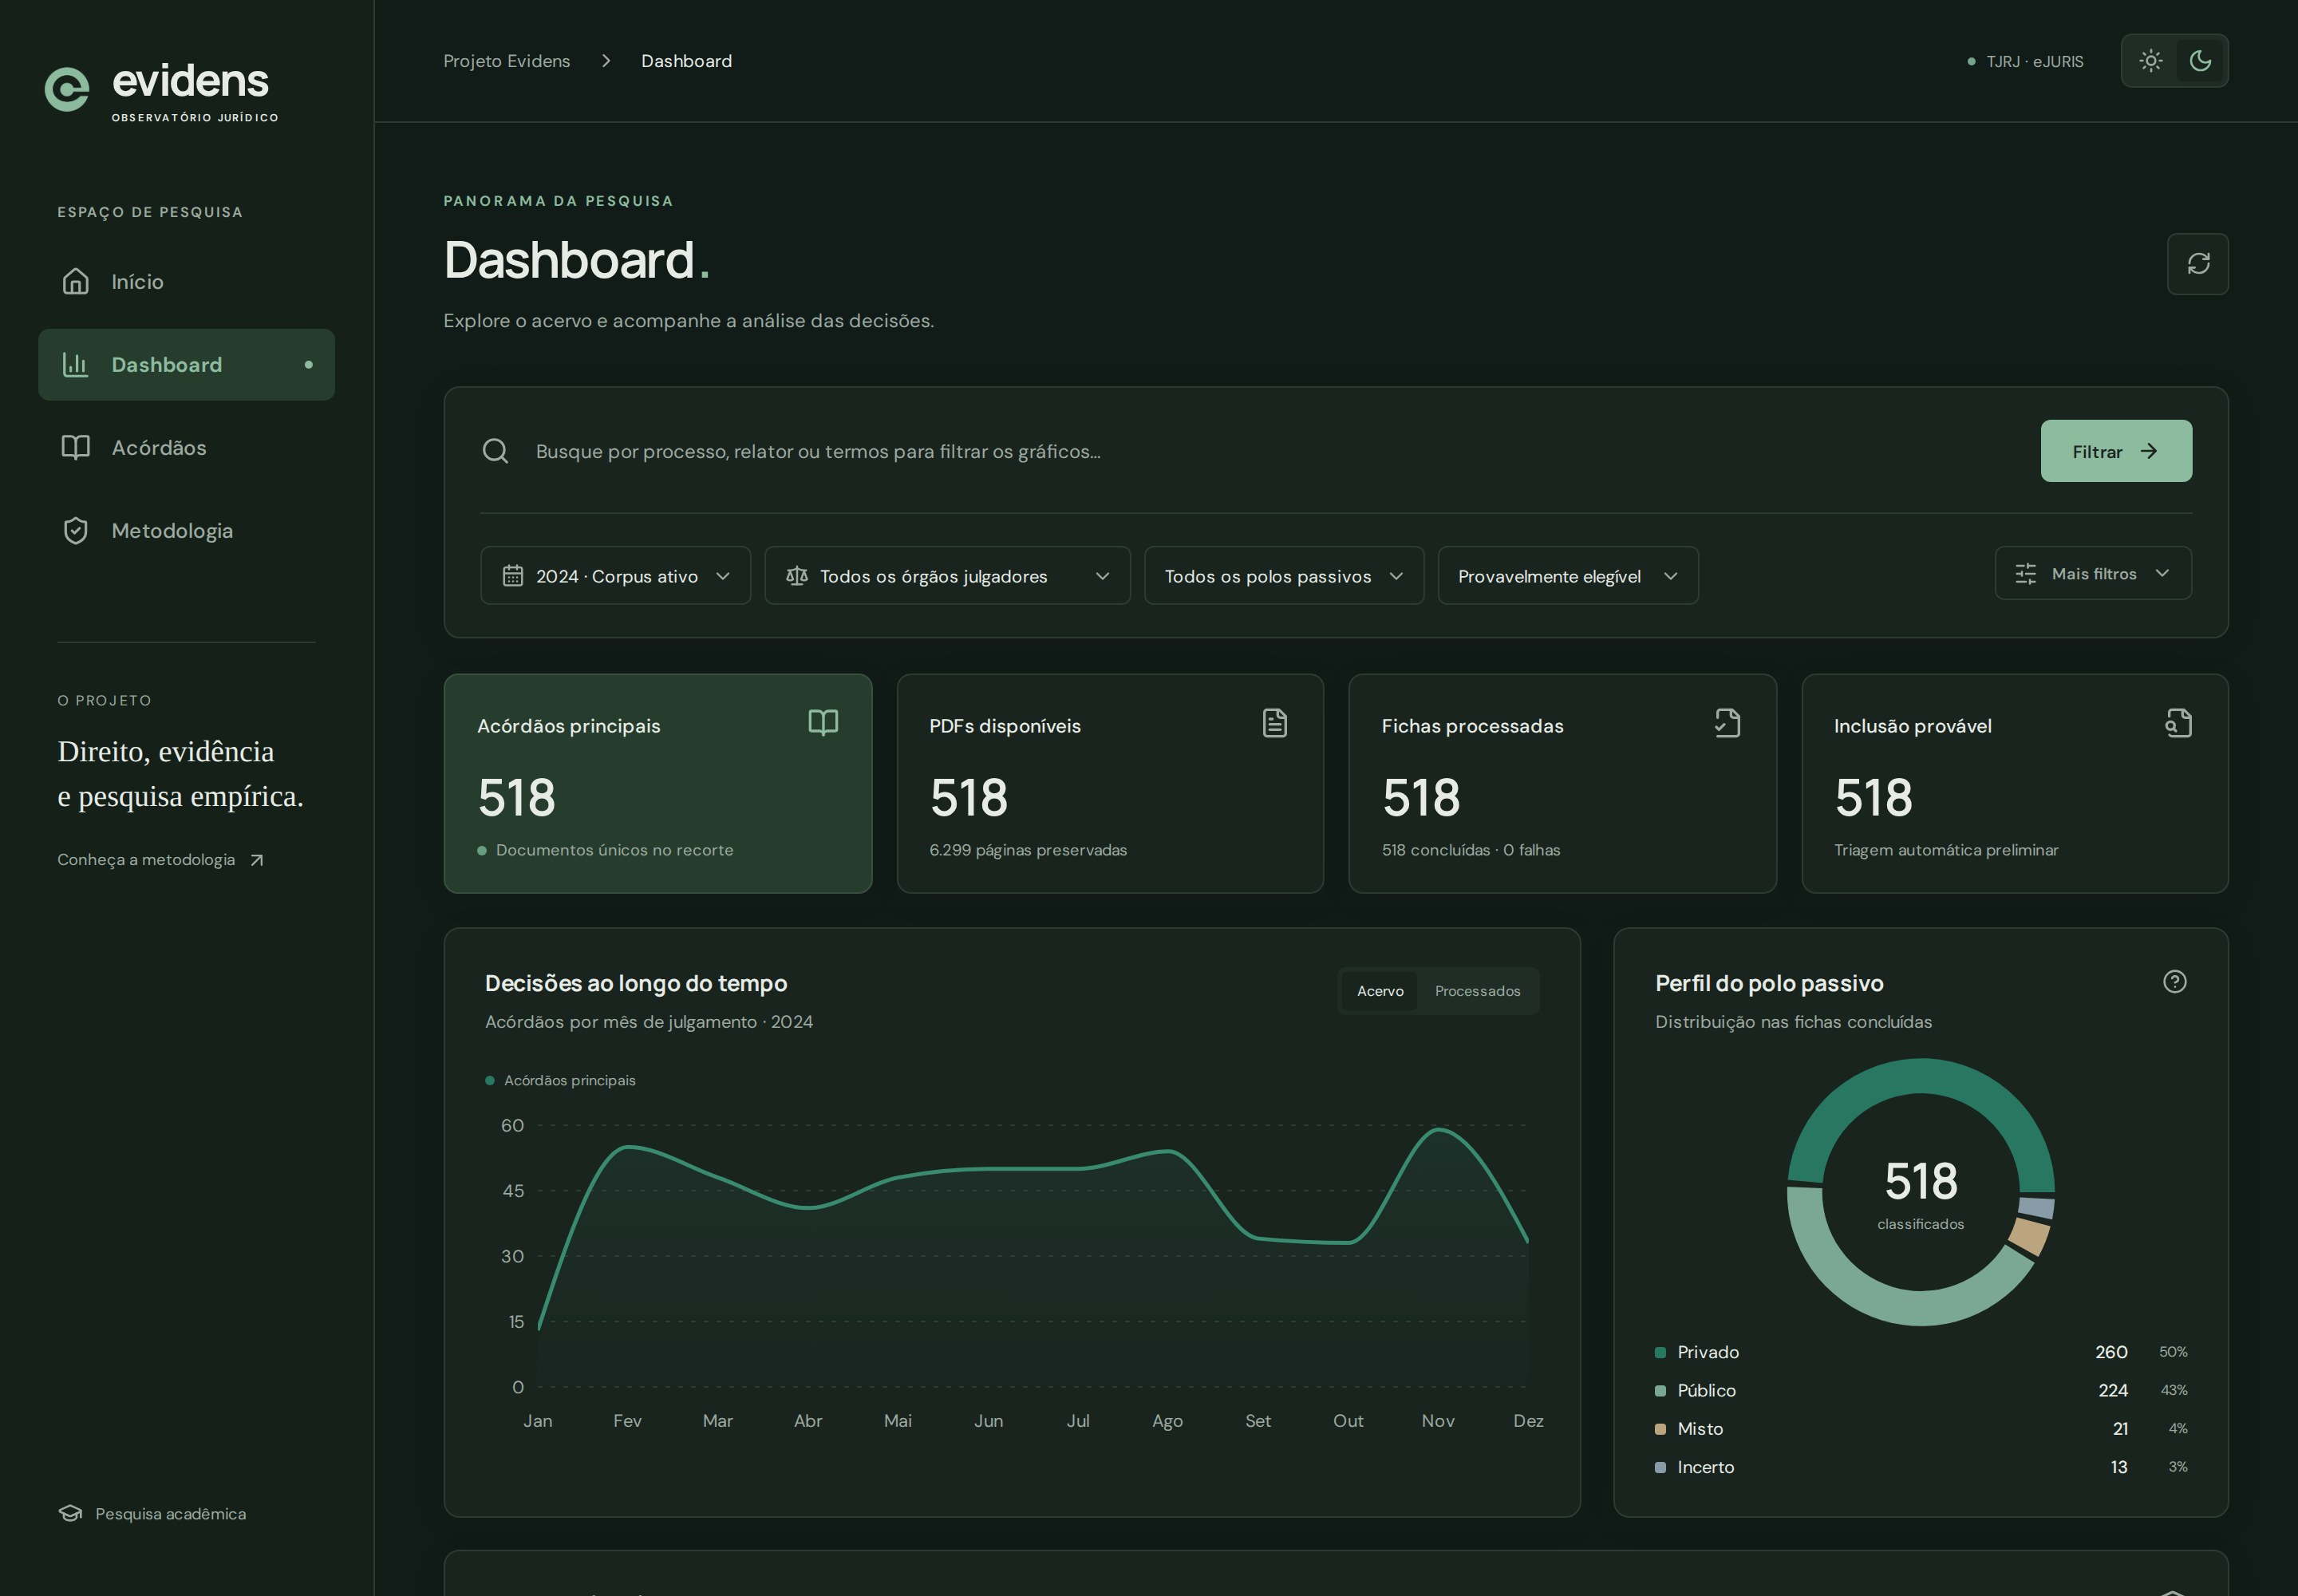
O painel público, em React 19 com TypeScript e Recharts, mostra os 518 casos. É só leitura, nunca expõe a resposta bruta do modelo e não hospeda PDFs: o link aponta para o tribunal. Nas imagens desta página, números de processo, nomes e trechos das decisões foram mascarados.
O que não funcionou
A primeira versão era um classificador por regex. Num piloto com 100 acórdãos sorteados, comparei as regras com um modelo anterior: a concordância foi de 47,9% na elegibilidade e 28,7% no polo passivo. Isso mede concordância, não acurácia, mas bastou para ver que regras não capturavam a argumentação. Aposentei as regras como classificador e o pipeline passou a usar só o modelo, com citações validadas.
Limites
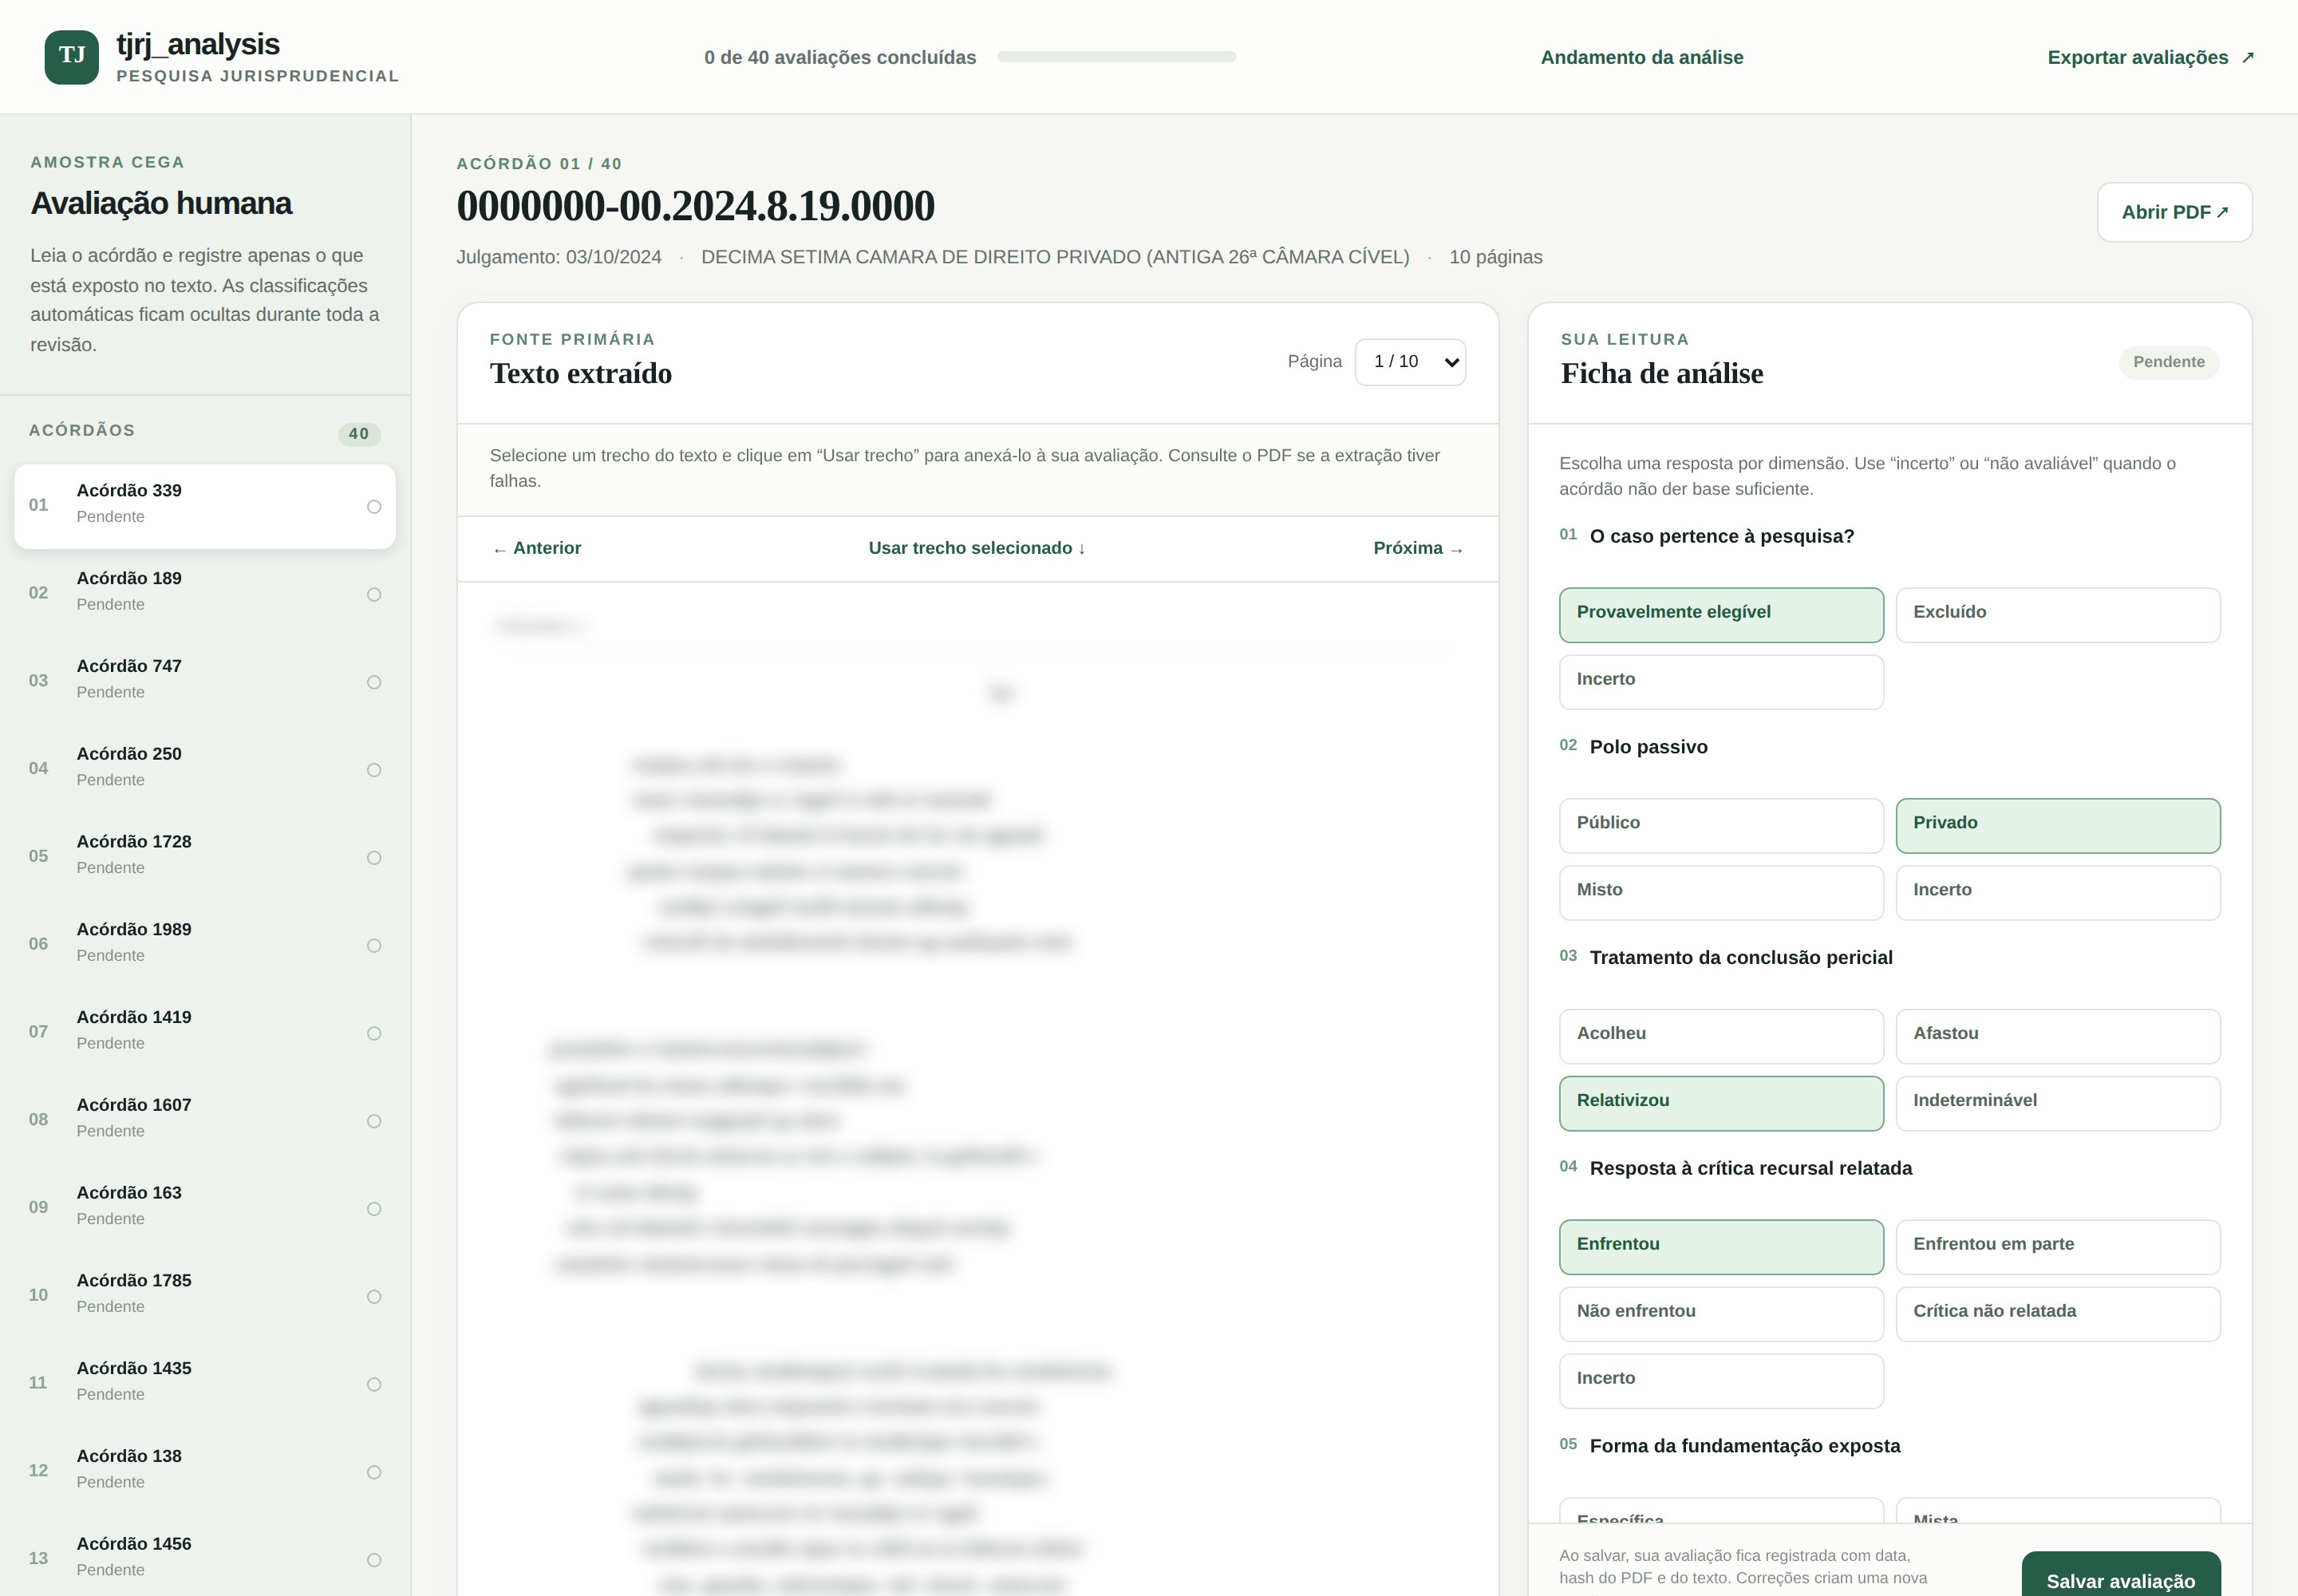
A auditoria humana tem infraestrutura pronta, com amostra cega estratificada e uma interface em Flask que esconde os rótulos do modelo até o fim da revisão, mas a validação humana não foi concluída. A classificação do modelo é preliminar.
O estudo é exploratório: não mede frequência do comportamento do tribunal, não avalia se a decisão foi certa e não deduz intenção de quem julgou. O silêncio do acórdão não prova a ausência de um argumento, e o corpus é o que três consultas recuperaram.
Para ler mais
Escrevi um artigo sobre o método da análise: IA para análise semântica de grandes volumes de dados: como fazer um modelo ler mil acórdãos e provar o que leu.
// screenshots