RAG na prática: do PDF da aula à resposta com fonte, com BM25 no celular e Claude
Como construí o MedRAG, um copiloto de estudos com RAG de ponta a ponta: ingestão com markitdown e OCR, chunking pela estrutura do texto, BM25 offline no Flutter e respostas do Claude com a fonte citada.
 Rafael Faria Ferreira
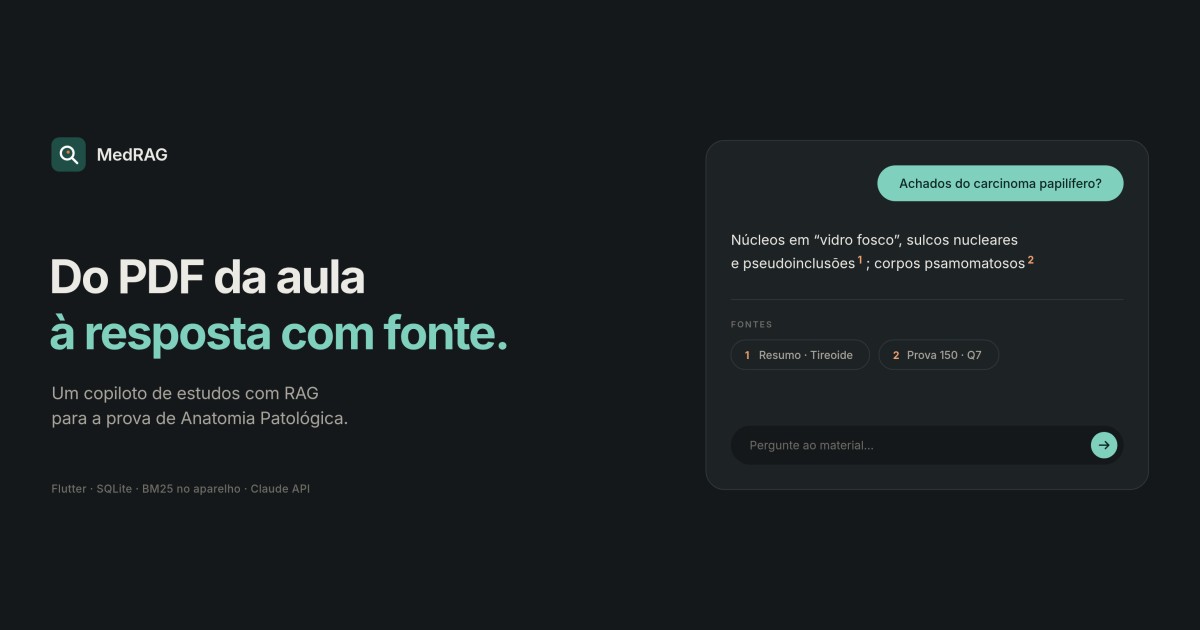
Minha namorada tinha poucas horas até a prova de Anatomia Patológica II. Ela já tinha estudado, mas o material estava espalhado em dois PDFs: um resumo das aulas com 40 páginas e um compilado de provas antigas com 119, que mistura texto digitado, foto de prova, print de formulário, gabarito de origens diferentes e anotação à mão. Ela não precisava ler mais nada. Precisava perguntar "qual a diferença entre hiperplasia folicular e linfoma folicular?" e receber uma resposta curta, baseada no material do professor, dizendo de onde aquilo saiu.
Esse é o problema que o RAG (Retrieval-Augmented Generation) resolve, e eu queria construir um de ponta a ponta, sem framework escondendo as decisões. O resultado é o MedRAG, um app Flutter com um copiloto que busca os trechos certos no próprio celular e manda para o Claude só o que importa. O código está aberto no GitHub. Neste artigo eu conto as quatro etapas e o que aprendi em cada uma.
O que é RAG, sem rodeio
Um modelo de linguagem responde com o que aprendeu no treino. Ele não conhece o resumo do professor, nem sabe que naquela disciplina "linfonodos reacionais" no enunciado quer dizer livres de neoplasia. A ideia do RAG é simples: antes de perguntar ao modelo, você busca no seu material os trechos que tratam do assunto e coloca esses trechos no prompt. O modelo passa a responder sobre o texto que você entregou, e pode citar de onde tirou cada coisa.
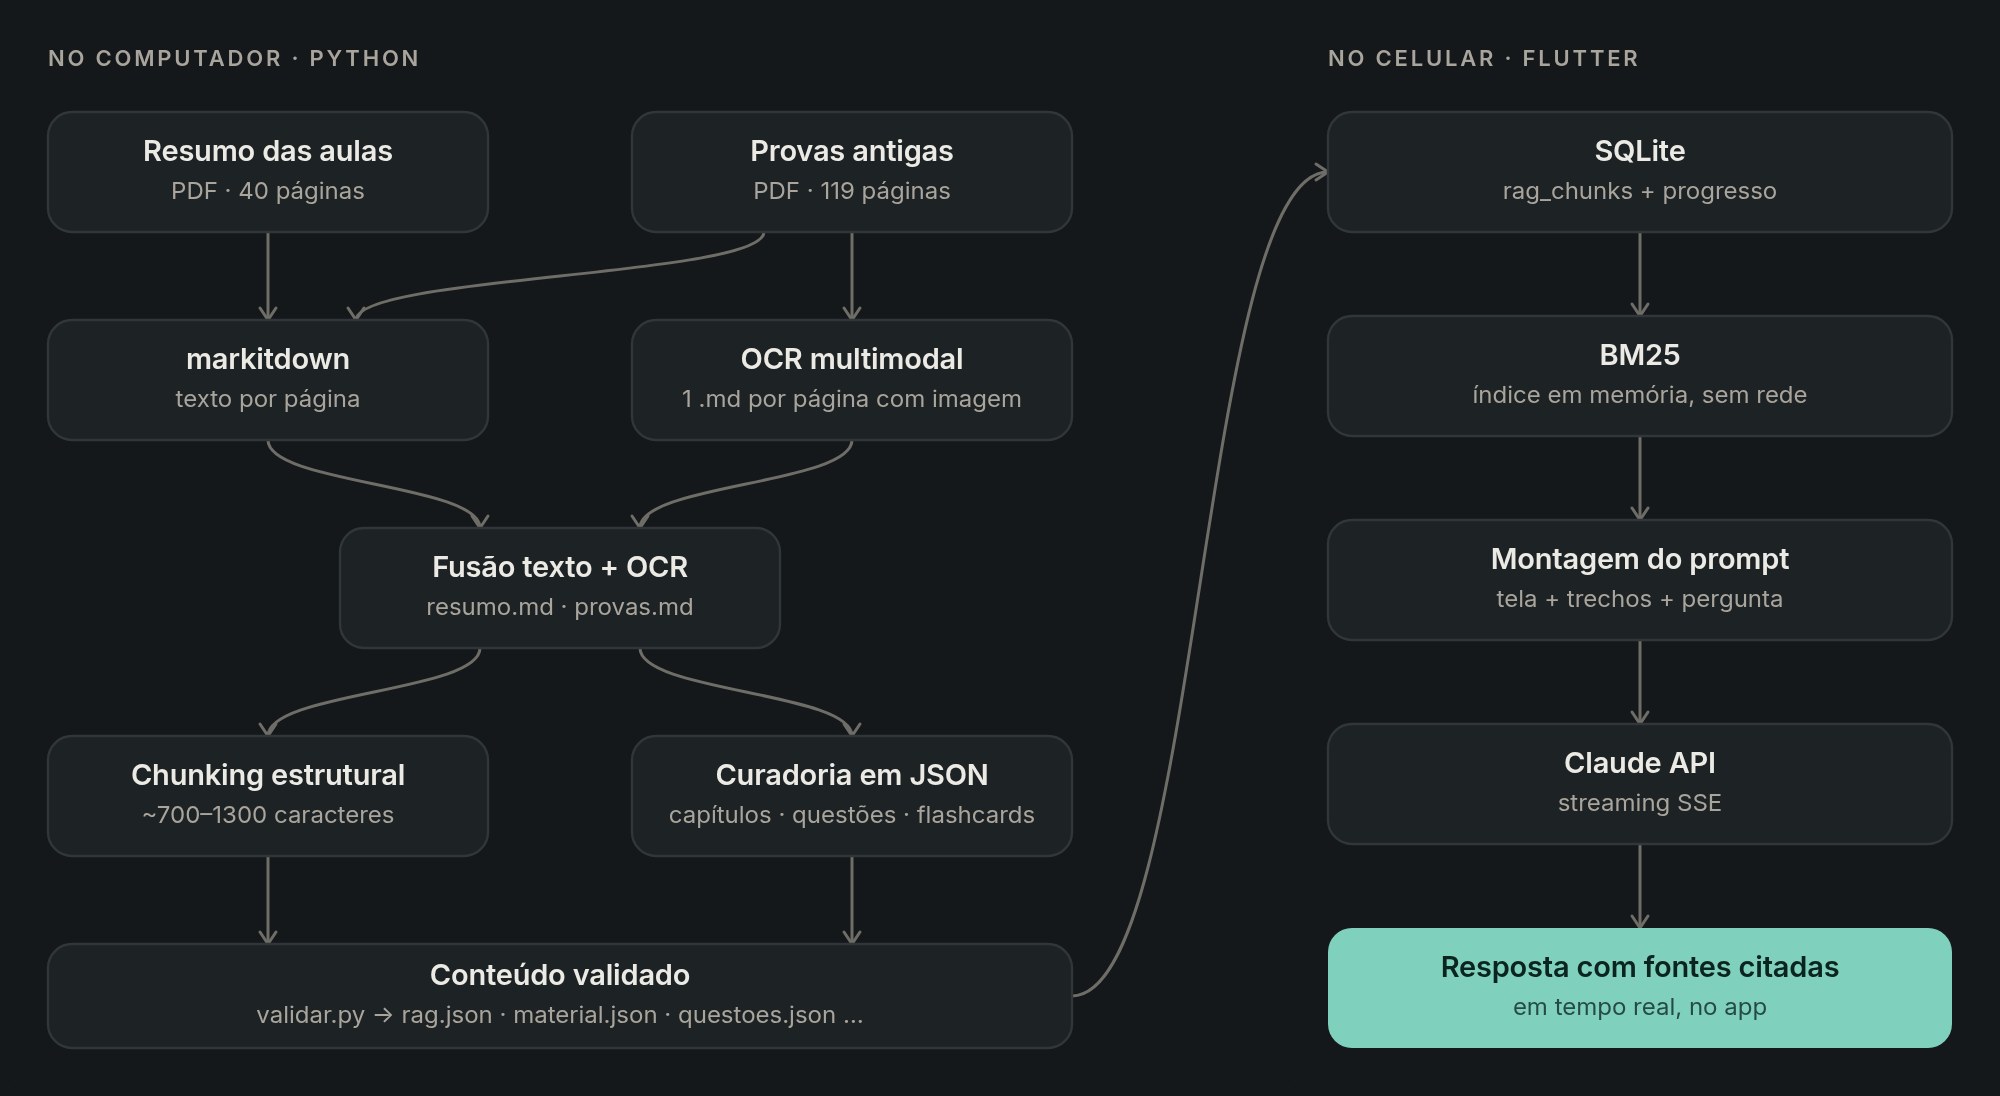
Na prática, o sistema tem quatro partes. A ingestão transforma os documentos em texto limpo. A indexação corta esse texto em pedaços (os chunks). A recuperação escolhe os pedaços certos para cada pergunta. A geração monta o prompt e mostra a resposta. A parte que mais dá trabalho costuma ser a primeira, e aqui não foi diferente.
1. Ingestão: o modelo só é tão bom quanto o texto que chega nele
Os dois PDFs pediam tratamentos diferentes. O resumo das aulas é texto digitado, e a dificuldade é saber em que página cada trecho está, para juntar a ele a leitura das imagens daquela página. O compilado de provas é o contrário: muita informação só existe na foto. A alternativa circulada, o "V" escrito à mão, a correção do professor na margem, nada disso sai numa extração de texto.
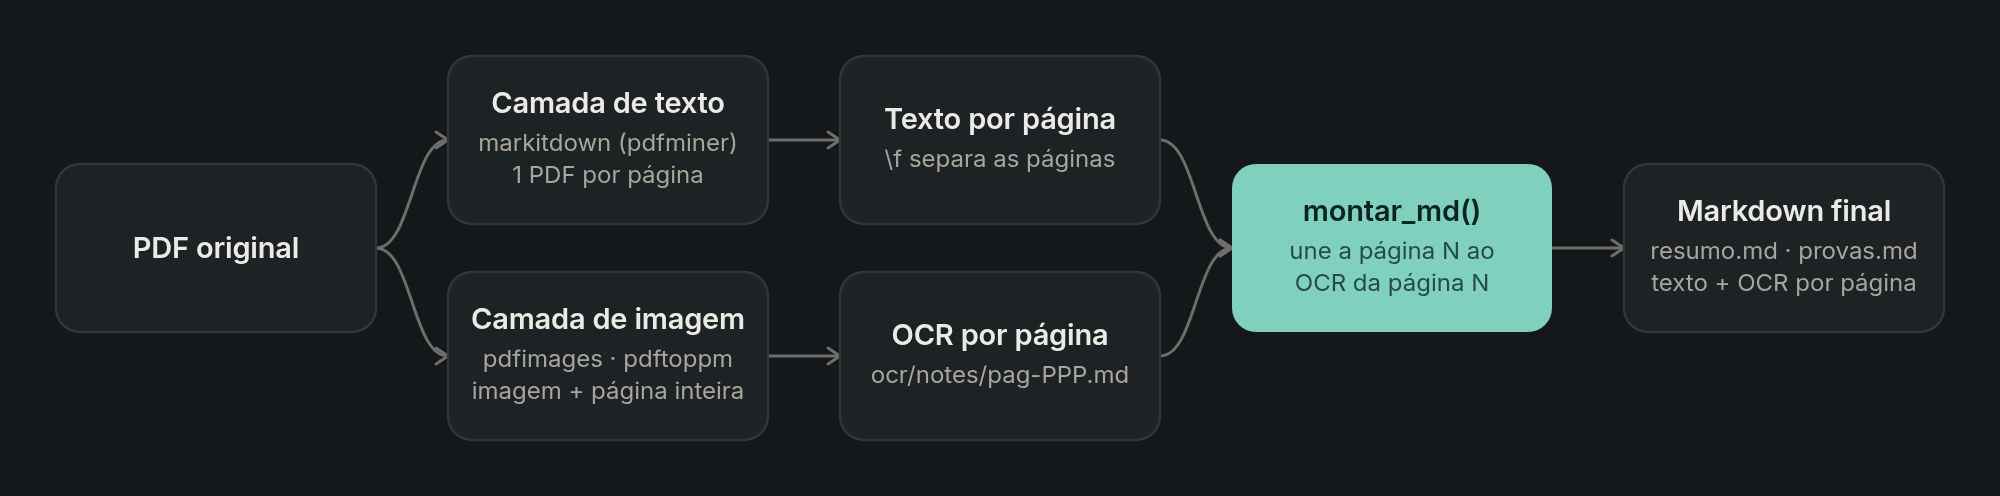
Para o texto usei o markitdown, da Microsoft, que converte PDF e outros formatos em Markdown pensado para LLMs. Rodei duas passagens no resumo. A primeira converte o documento inteiro e gera o texto mais limpo, com parágrafos e listas inteiros. A segunda converte página a página, o que às vezes quebra um parágrafo no meio, mas é a única forma de saber onde cada página começa. Depois eu alinho as duas: normalizo os textos (NFKC, minúsculas, só letras e números), procuro as primeiras 30 letras de cada página dentro do texto contínuo e marco ali o número da página. Fico com o melhor das duas versões.
Para as imagens usei OCR com um modelo multimodal, que lê escrita à mão e foto torta com reflexo muito melhor que um OCR clássico. Extraí as imagens embutidas e também renderizei as páginas inteiras, porque a anotação à mão às vezes fica fora da imagem. O que fez diferença foi impor um formato fixo de saída, separando o que está impresso do que foi escrito à mão:
## Página 37 — foto de prova
**Descrição:** prova de 2024.1, folha com reflexo, alternativa C circulada.
**Transcrição (OCR):**
...texto impresso, com [ilegível] onde não dá para ler...
**Anotações manuscritas:**
...alternativas circuladas, V/F marcados, correções do professor...
A anotação à mão é a melhor pista do gabarito verdadeiro, e virou parte de uma ordem de confiança que acompanha o sistema até o prompt: gabarito oficial, depois a marcação visível na foto, depois o gabarito de aluno, e por último o gabarito gerado por IA, que é o menos confiável. Quando um trecho estava ilegível, a regra era recortar e ampliar a imagem antes de desistir.
No fim, um script intercala, página a página, o texto do markitdown e o bloco de OCR, e gera dois arquivos Markdown. Eles são a fonte única de tudo que vem depois: os chunks do RAG e também a curadoria do resto do app (capítulos, 141 questões com gabarito e 259 flashcards). O build é idempotente, então rodar de novo sem mudar a origem gera exatamente os mesmos arquivos.
2. Chunking: a estrutura do texto importa mais que o algoritmo de busca
Se eu tivesse que escolher uma lição deste projeto, seria esta. Um chunk precisa caber no prompt e fazer sentido sozinho, porque é assim que ele vai chegar ao modelo, fora de contexto. Cortar a cada N caracteres produz pedaços que começam no meio de uma frase e terminam no meio de uma questão. Por isso o corte respeita a estrutura do documento.
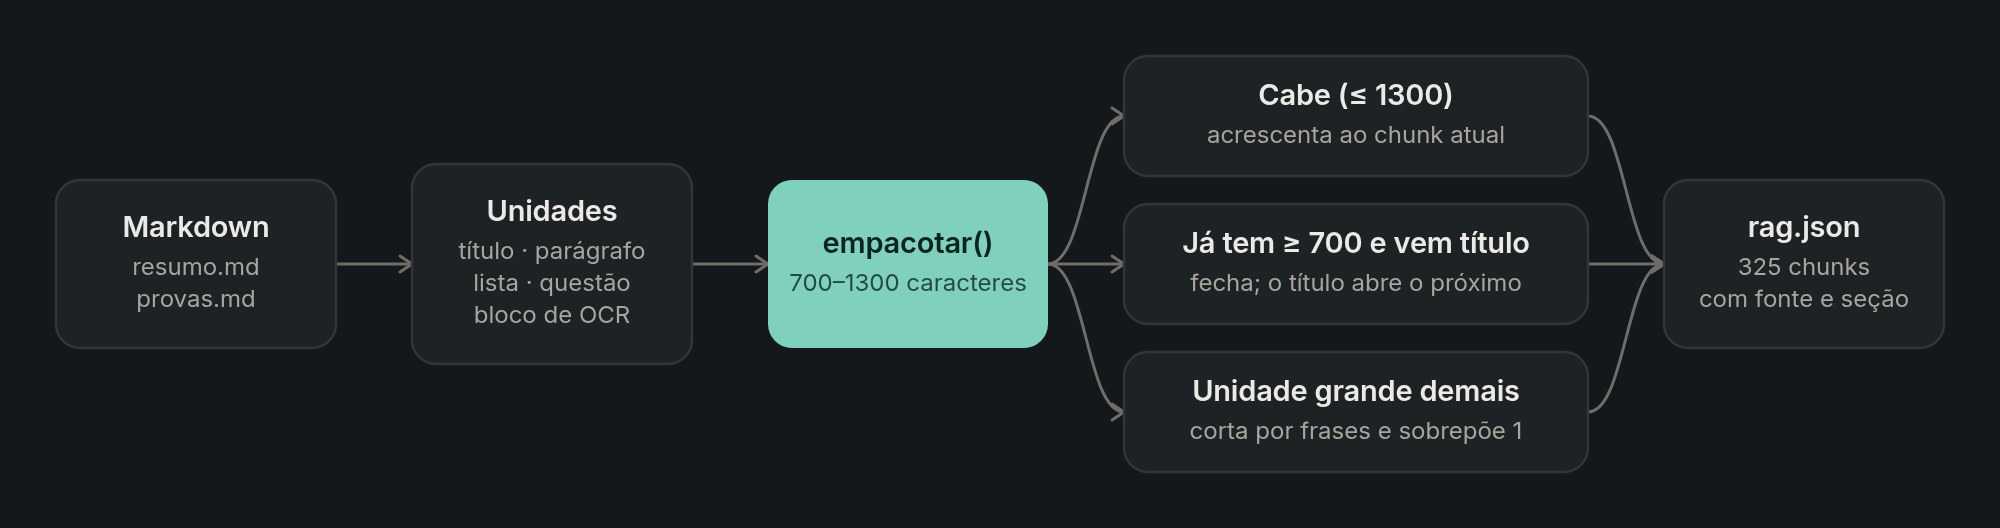
Regra | Por quê |
|---|---|
Alvo de 700 a 1.300 caracteres | Grande o bastante para trazer um raciocínio inteiro, pequeno o bastante para mandar 7 trechos por pergunta |
Corta antes de um título e nunca deixa título no fim | O chunk começa pelo assunto, e o título ajuda na busca |
Sobreposição de uma frase quando a prosa é cortada | A ideia que atravessa o corte não se perde |
Prefixo | O pedaço recuperado sozinho continua dizendo de onde veio |
Junta trechos muito curtos e descarta restos sem conteúdo | Evita chunks inúteis como "não tem foto da prova" |
Fonte e seção legíveis, como | Viram a citação que aparece na resposta |
O resultado foram 325 chunks: 77 do resumo e 248 das provas antigas, com mediana de 1.137 caracteres. Nenhum ajuste fino de parâmetro de busca melhorou tanto a qualidade das respostas quanto essas regras de corte.
3. Recuperação: por que BM25 e não embeddings
O caminho padrão de RAG hoje é gerar embeddings e guardar num banco vetorial. Aqui eu escolhi BM25, uma busca lexical clássica, rodando no celular e sem rede. Foram três motivos. O vocabulário é técnico e exato: CD20, bcl-2, Reed-Sternberg, psamoma. Nesse domínio acertar o termo exato vale mais do que a semelhança semântica, e embeddings genéricos se confundem com siglas. O corpus é pequeno, 325 chunks, e o índice é montado em memória em milissegundos. E a solução não depende de nada: nenhum modelo de embedding, nenhuma chamada extra de API, nenhum banco vetorial. A única chamada de rede do app é a do Claude.
O que mais deu trabalho foi a tokenização para português médico. Tudo vai para minúsculas e perde acento, as siglas são normalizadas (bcl-2 vira bcl2, CD20+ vira cd20), as stopwords saem e um radical bem leve junta "folículos", "folicular" e "foliculares". O título da seção entra duas vezes no texto indexado, para pesar mais.
"Os folículos têm CD20+ e BCL-2?"
  → sem acento, minúsculas  → "os foliculos tem cd20+ e bcl-2?"
  → siglas normalizadas     → cd20, bcl2
  → sem stopwords           → foliculos, cd20, bcl2
  → radical leve            → [folicul, cd20, bcl2]
A pontuação é o BM25 de livro, com k1 = 1,4 e b = 0,72. O idf premia termos raros, então "psamoma" vale mais que "tireoide", e o b impede que um chunk ganhe só por ser comprido. Ficam os 7 melhores, desde que tenham pelo menos 28% da nota do primeiro. Esse corte relativo evita mandar ruído quando só dois trechos são relevantes de verdade.
O truque do contexto da tela
Estudante não pergunta como quem escreve consulta de busca. Ela abre o capítulo de linfadenopatias, lê, e pergunta "explica isso de outro jeito". Essa pergunta sozinha não recupera nada. A solução foi somar à consulta o que está aberto na tela, com peso menor: os termos da pergunta valem 1,0 e os termos do título do capítulo e dos primeiros 400 caracteres da tela valem 0,35. A pergunta vaga passa a puxar o assunto certo, e uma pergunta específica sobre outro tema continua ganhando, porque os termos dela pesam quase três vezes mais.
final q = <String, double>{};
for (final t in tokens(pergunta)) {
  q[t] = (q[t] ?? 0) + 1.0;
}
for (final t in tokens(contextoDaTela)) {
  q[t] = (q[t] ?? 0) + 0.35; // reforço, não substituição
}
Cada tela do app registra o seu contexto ao abrir, numa pilha. O copiloto é um botão flutuante presente em todas as telas e sempre sabe o que ela está vendo.
4. Geração: o prompt é uma interface
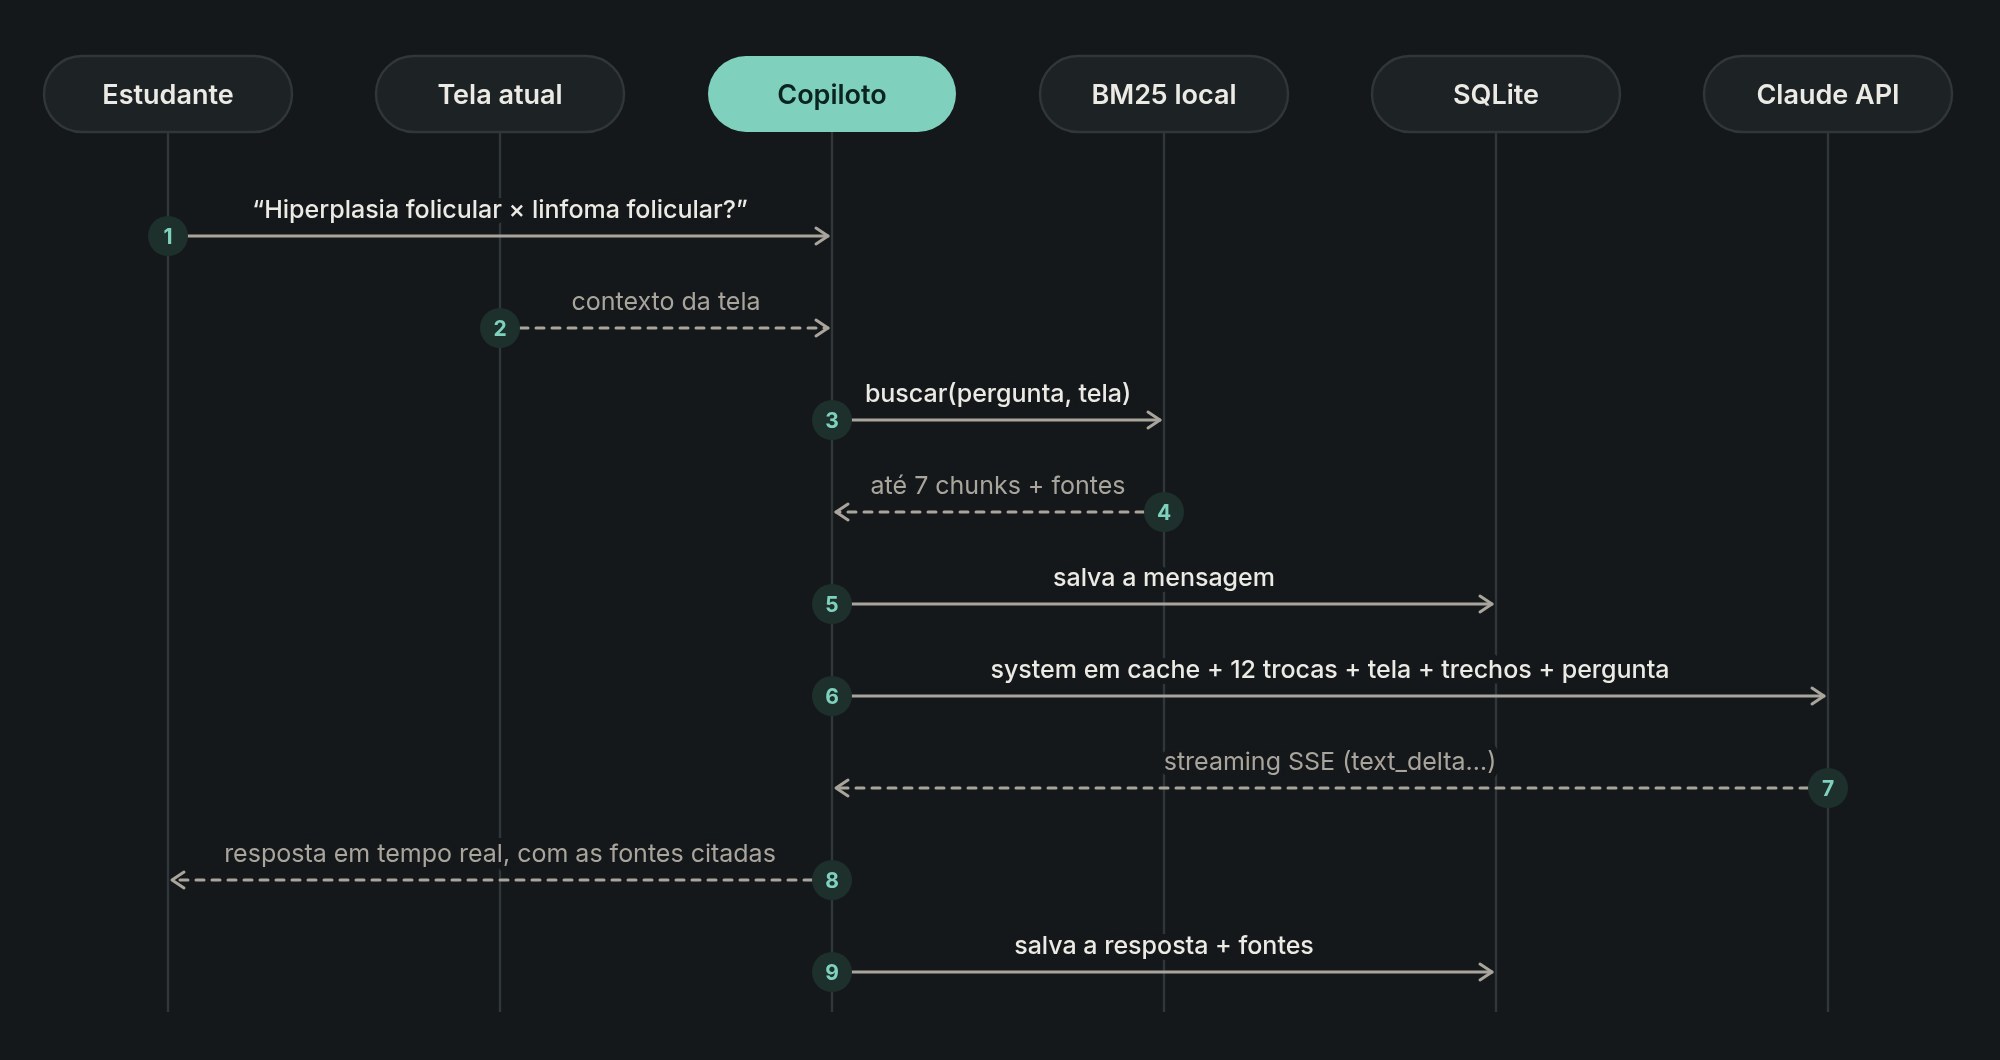
Cada turno manda ao Claude três blocos separados por tags XML, o que deixa claro para o modelo o que é contexto, o que é material de consulta e o que é a pergunta:
<contexto_da_tela onde="Linfadenopatias › Padrão folicular">
  ...o que ela está vendo, até 7.000 caracteres...
</contexto_da_tela>

<trechos_recuperados>
[Resumo · Linfadenopatias — HIPERPLASIA FOLICULAR]
...chunk...
---
[Prova 148 · questões 3–5]
...chunk...
</trechos_recuperados>

<pergunta>
Qual a diferença entre hiperplasia folicular e linfoma folicular?
</pergunta>
Algumas decisões aqui fizeram diferença real.
- Os trechos vão só no turno atual. O histórico leva apenas o texto das últimas 12 mensagens, sem os trechos antigos. O prompt não cresce sem limite, e a busca é refeita a cada pergunta, então uma conversa que muda de assunto recupera o material novo.
- O system prompt fica em cache. Ele é longo e igual em todas as chamadas, então marcá-lo com
cache_controlreduz custo e latência a partir da segunda pergunta. - A hierarquia de fontes está no próprio prompt. Gabarito oficial e resumo valem mais que gabarito gerado por IA. Quando a resposta não está nos trechos, o modelo diz isso numa frase e marca o resto como "Complemento". É isso que impede o RAG de virar um chat genérico com cara de material oficial.
- As regras da disciplina viram instrução. Diagnóstico completo, nada de diagnóstico de linfoma sem imuno-histoquímica, marcadores citados com + e −. O que o professor cobra na correção vira comportamento do copiloto.
- Modos de estudo. Ela pode pedir para ser testada, uma pergunta por vez com correção, ou colar uma resposta discursiva para ser corrigida contra a resposta-modelo e o checklist da questão.
As fontes dos trechos recuperados são guardadas junto com a resposta e aparecem como chips embaixo dela. Num material com gabaritos que se contradizem, ver "Resumo · Tireoide" ou "Prova 150 · Q7" ao lado da resposta é o que dá confiança para usar.
O cliente HTTP é escrito em Dart, sem SDK, com streaming por SSE e mensagens de erro em português para os casos comuns: chave recusada, limite atingido, serviço sobrecarregado, sem internet. Conteúdo biomédico às vezes esbarra num classificador de segurança por engano, então o pedido usa o fallback do lado do servidor da API: se o modelo principal recusar, a própria API refaz o pedido em outro modelo. Nenhuma chave vem embutida no app. Cada pessoa cola a própria chave, que fica só no SQLite do aparelho e vai apenas para a API da Anthropic. Para uso pessoal isso basta; para publicar o app para outras pessoas, o certo seria um backend intermediário.
O que eu faria diferente
BM25 foi a escolha certa para este corpus, mas tem um limite claro: se a pergunta usa um sinônimo que não aparece no texto, a busca não encontra. O próximo passo natural é uma busca híbrida, BM25 somado a embeddings, com um re-ranking dos candidatos antes de montar o prompt. Outro passo que vale a pena é um conjunto de avaliação: umas 30 perguntas com os trechos que deveriam voltar, para medir recall a cada mudança no chunking ou na tokenização, em vez de testar na mão. Em RAG, mudar a regra de corte muda tudo, e sem medir é fácil melhorar um caso e piorar dez.
O que fica
- A ingestão é a maior parte do trabalho. markitdown resolve o texto, mas foto de prova pede OCR com visão e um formato de saída rígido.
- Chunking com estrutura vale mais que algoritmo sofisticado. Respeitar títulos, questões e frases, e dar a cada chunk uma fonte legível, foi a maior alavanca de qualidade.
- BM25 é um ótimo começo em domínio técnico e corpus pequeno: simples, explicável, offline e bom com siglas.
- O que está na tela é um sinal barato e forte. Somar o contexto à consulta, com peso menor, resolve pergunta vaga sem pedir que a pessoa reescreva.
- Citar a fonte é o que transforma uma resposta plausível numa resposta em que dá para confiar.
O código, os diagramas e as instruções para rodar estão no projeto MedRAG e no repositório do GitHub.